
Назад
Открываем код первого таджикского голоса на базе LLM
Новая глава ИИ для малоресурсных языков начинается здесь
Коротко:
Мы открываем код раннего чекпоинта первой модели синтеза речи (Text-to-Speech) на базе LLM. Модель обучена всего на 35 часах аудиоданных и при этом генерирует речь исключительно высокого качества, приятную на слух.
Демо можно попробовать здесь:
https://huggingface.co/spaces/re-skill/tajik-tts
Наша модель по-прежнему учится предсказывать следующий токен, но мы преобразуем аудиосигнал в последовательности дискретных токенов, с которыми при обучении можно работать почти так же, как с текстом.
Контекст
Классические модели синтеза речи (TTS) давно отлично справляются с клонированием голоса и синтезом речи. Обычно они работают в два этапа: сначала модель вроде Tacotron преобразует текст в промежуточное акустическое представление (например, spectrogram), а затем vocoder превращает это представление в аудиосигнал. Такие системы умеют создавать реалистичные голоса, но их главной задачей было воспроизвести звучание конкретного диктора, а вести живой разговор с учётом контекста они способны лишь в ограниченной мере.
Появление больших языковых моделей (LLM) открывает серьёзные возможности для развития таких систем. Встраивая LLM в конвейеры TTS, мы можем использовать их развитые способности к рассуждению и пониманию контекста и создавать по-настоящему разговорные речевые системы. Такие системы не просто клонируют голос: они интерпретируют контекст, подстраиваются под ход диалога и дают ответы, которые звучат естественно и живо. По сути, LLM открывают новое измерение, в котором синтез речи уже не сводится к воспроизведению звука: он делает возможным умный разговор с учётом контекста.
На практике эти возможности можно объединить с помощью каскадного подхода в системе преобразования речи в речь (speech-to-speech). Обычно такая система состоит из трёх отдельных модулей:
Распознавание речи (Speech-to-Text, STT): преобразует входящую речь в текст.
Большая языковая модель (LLM): обрабатывает расшифрованный текст и рассуждает над ним, чтобы понять контекст и сформировать ответ для диалога.
Синтез речи (Text-to-Speech, TTS): превращает текст, сгенерированный LLM, обратно в естественно звучащую речь.
Каскадный метод сочетает сильные стороны каждого специализированного компонента. Однако у этого подхода есть ограничения.
Одна из главных проблем в том, что LLM не улавливает всего богатства входящей речи.
Речь несёт тонкие сигналы: интонацию, ритм, эмоции и просодические нюансы, которые часто теряются при переводе в текст. В результате LLM, обрабатывая расшифровку, получает сильно упрощённое представление исходного аудио. Из-за потери деталей модели сложнее давать ответы, которые в полной мере передают выразительность исходной речи, и синтезированный результат может звучать менее живо и хуже учитывать контекст.
Эту проблему могла бы решить прямая интеграция речи с LLM, но она сопряжена с серьёзными трудностями. В отличие от текста, речь представляет собой непрерывный высокоразмерный сигнал. LLM рассчитаны на работу с дискретными токенами, поэтому, чтобы перевести речь в понятный им формат, нужны дополнительные шаги. Существующие методы решают эту задачу двумя основными способами:
Аудиоэнкодеры: в некоторых подходах специальные аудиоэнкодеры преобразуют непрерывную речь в дискретные токены, прежде чем передать их в LLM. Задача метода в том, чтобы сохранить важные акустические признаки (например,
intonationиrhythm) и при этом перевести сигнал в формат, который LLM понимают нативно.Нейронные кодеки: они преобразуют аудиосигнал в последовательности дискретных токенов, с которыми можно работать почти так же, как с текстом. Такие кодеки, например те, что используются в моделях
DAC,EncodecилиXCodec, позволяют и TTS, и системам speech-to-speech использовать токенную архитектуру LLM. Сокращая разрыв между непрерывным аудиосигналом и дискретными последовательностями токенов, которые нужны LLM, нейронные кодеки упрощают интеграцию и делают обучение и инференс моделей эффективнее.
Несмотря на эти новшества, у каждого метода есть свои компромиссы. Аудиоэнкодерам приходится искать баланс между сохранением важной информации и потребностью в компактных дискретных представлениях. Нейронные кодеки, в свою очередь, сталкиваются с проблемой частоты токенов (речь обычно порождает намного больше токенов в секунду, чем текст) и с риском потерять тонкие акустические детали при квантовании.
Подведём итог. Классические модели TTS дают прочную основу для качественного клонирования голоса и синтеза речи, а способность LLM к рассуждению заметно расширяет круг возможных сценариев, потому что делает возможным живое взаимодействие с учётом контекста. Каскадный конвейер STT → LLM → TTS представляет собой практичный способ такой интеграции, но у него есть неотъемлемые проблемы: ошибки переходят от модуля к модулю, а всё богатство речевого сигнала уловить трудно. Развитие аудиоэнкодеров и нейронных кодеков критически важно, чтобы преодолеть эти препятствия. Оно прокладывает путь речевым системам нового поколения, которые органично сочетают понимание естественного языка с высококачественным синтезом звука.
Технический обзор
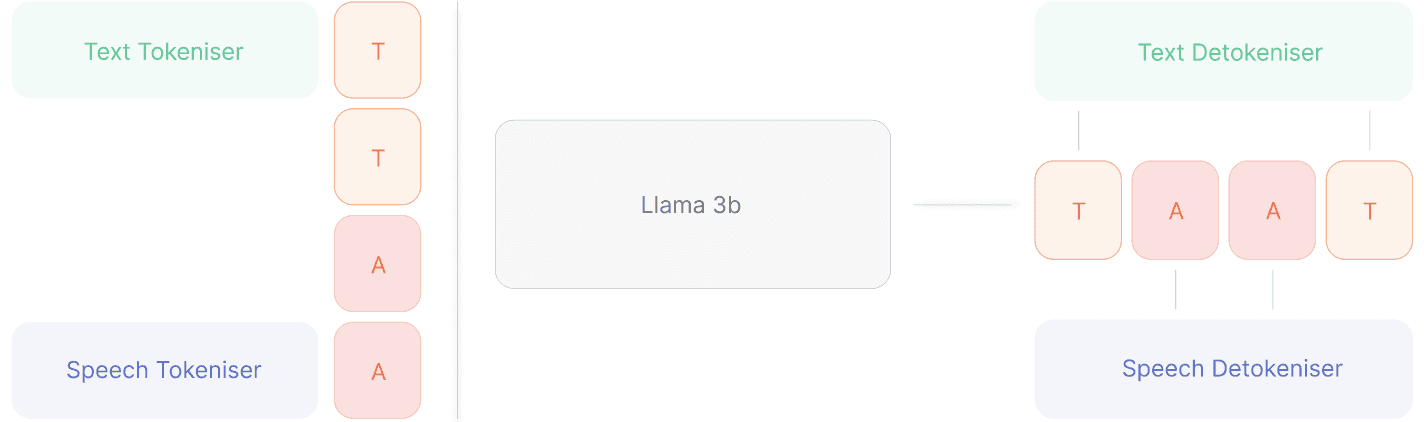
Архитектура модели
Мы стоим на плечах гигантов: веса инициализированы из уже имеющейся у нас базовой модели Orpheus-3b-0.1-pretrained. Затем мы продолжили обучение этой базовой модели на данных конкретного языка. Эти данные представляли собой пары «текст и речь».
Модель Orpheus построена на основе Llama-3B и сочетает LLM с многомасштабным нейронным аудиокодеком SNAC (Multi-Scale Neural Audio Codec). Нейронные кодеки преобразуют аудиосигнал в последовательности дискретных токенов, с которыми можно работать почти так же, как с текстом.
SNAC представляет собой продвинутый кодек на основе остаточного векторного квантования (Residual Vector Quantization, RVQ). Он захватывает аудиоинформацию на разных временных разрешениях, чтобы эффективно сжимать звук и детально его восстанавливать.
Модель по-прежнему учится предсказывать следующий токен. Токен здесь означает то, что выдаёт нейронный кодек SNAC, то есть аудиосигнал, преобразованный в последовательность дискретных токенов, с которыми можно работать почти так же, как с текстом.
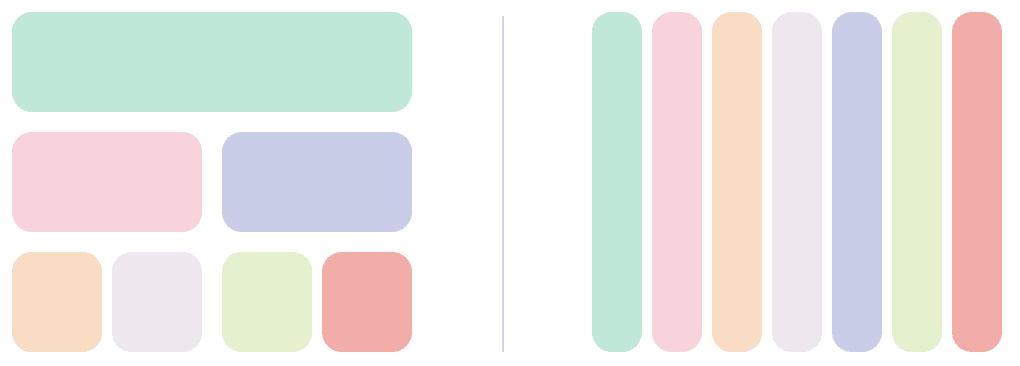
SNAC выдаёт токены с разной частотой, и мы разворачиваем их в одну последовательность, как показано на схеме
Чтобы обрабатывать несколько потоков токенов от SNAC в рамках стандартной архитектуры LLM, Orpheus генерирует одну плоскую последовательность токенов (7 tokens per audio frame sequentially). Модель обеспечивает потоковую генерацию с низкой задержкой (от ~200ms до ~25-50 ms при потоковой подаче текста в KV-кэш), пригодную для приложений реального времени. Для этого используется оптимизированное декодирование со скользящим окном в декодере SNAC, благодаря чему звук идёт плавно, без щелчков.
Orpheus делает особый акцент на выразительной, эмоциональной речи и поддерживает клонирование голоса в режиме zero-shot по коротким аудиофрагментам.
Заключение
Надеемся, что эта модель станет прочной основой, которую сообщество сможет обучать и дальше. Мы продолжим собирать данные, чтобы выпускать ещё более качественные модели синтеза таджикской речи. Если вы хотите поделиться данными, напишите нам на join@re-skill.io
https://huggingface.co/re-skill/orpheus-tj-early
Модель можно запустить и локально на Mac с чипом серии M: